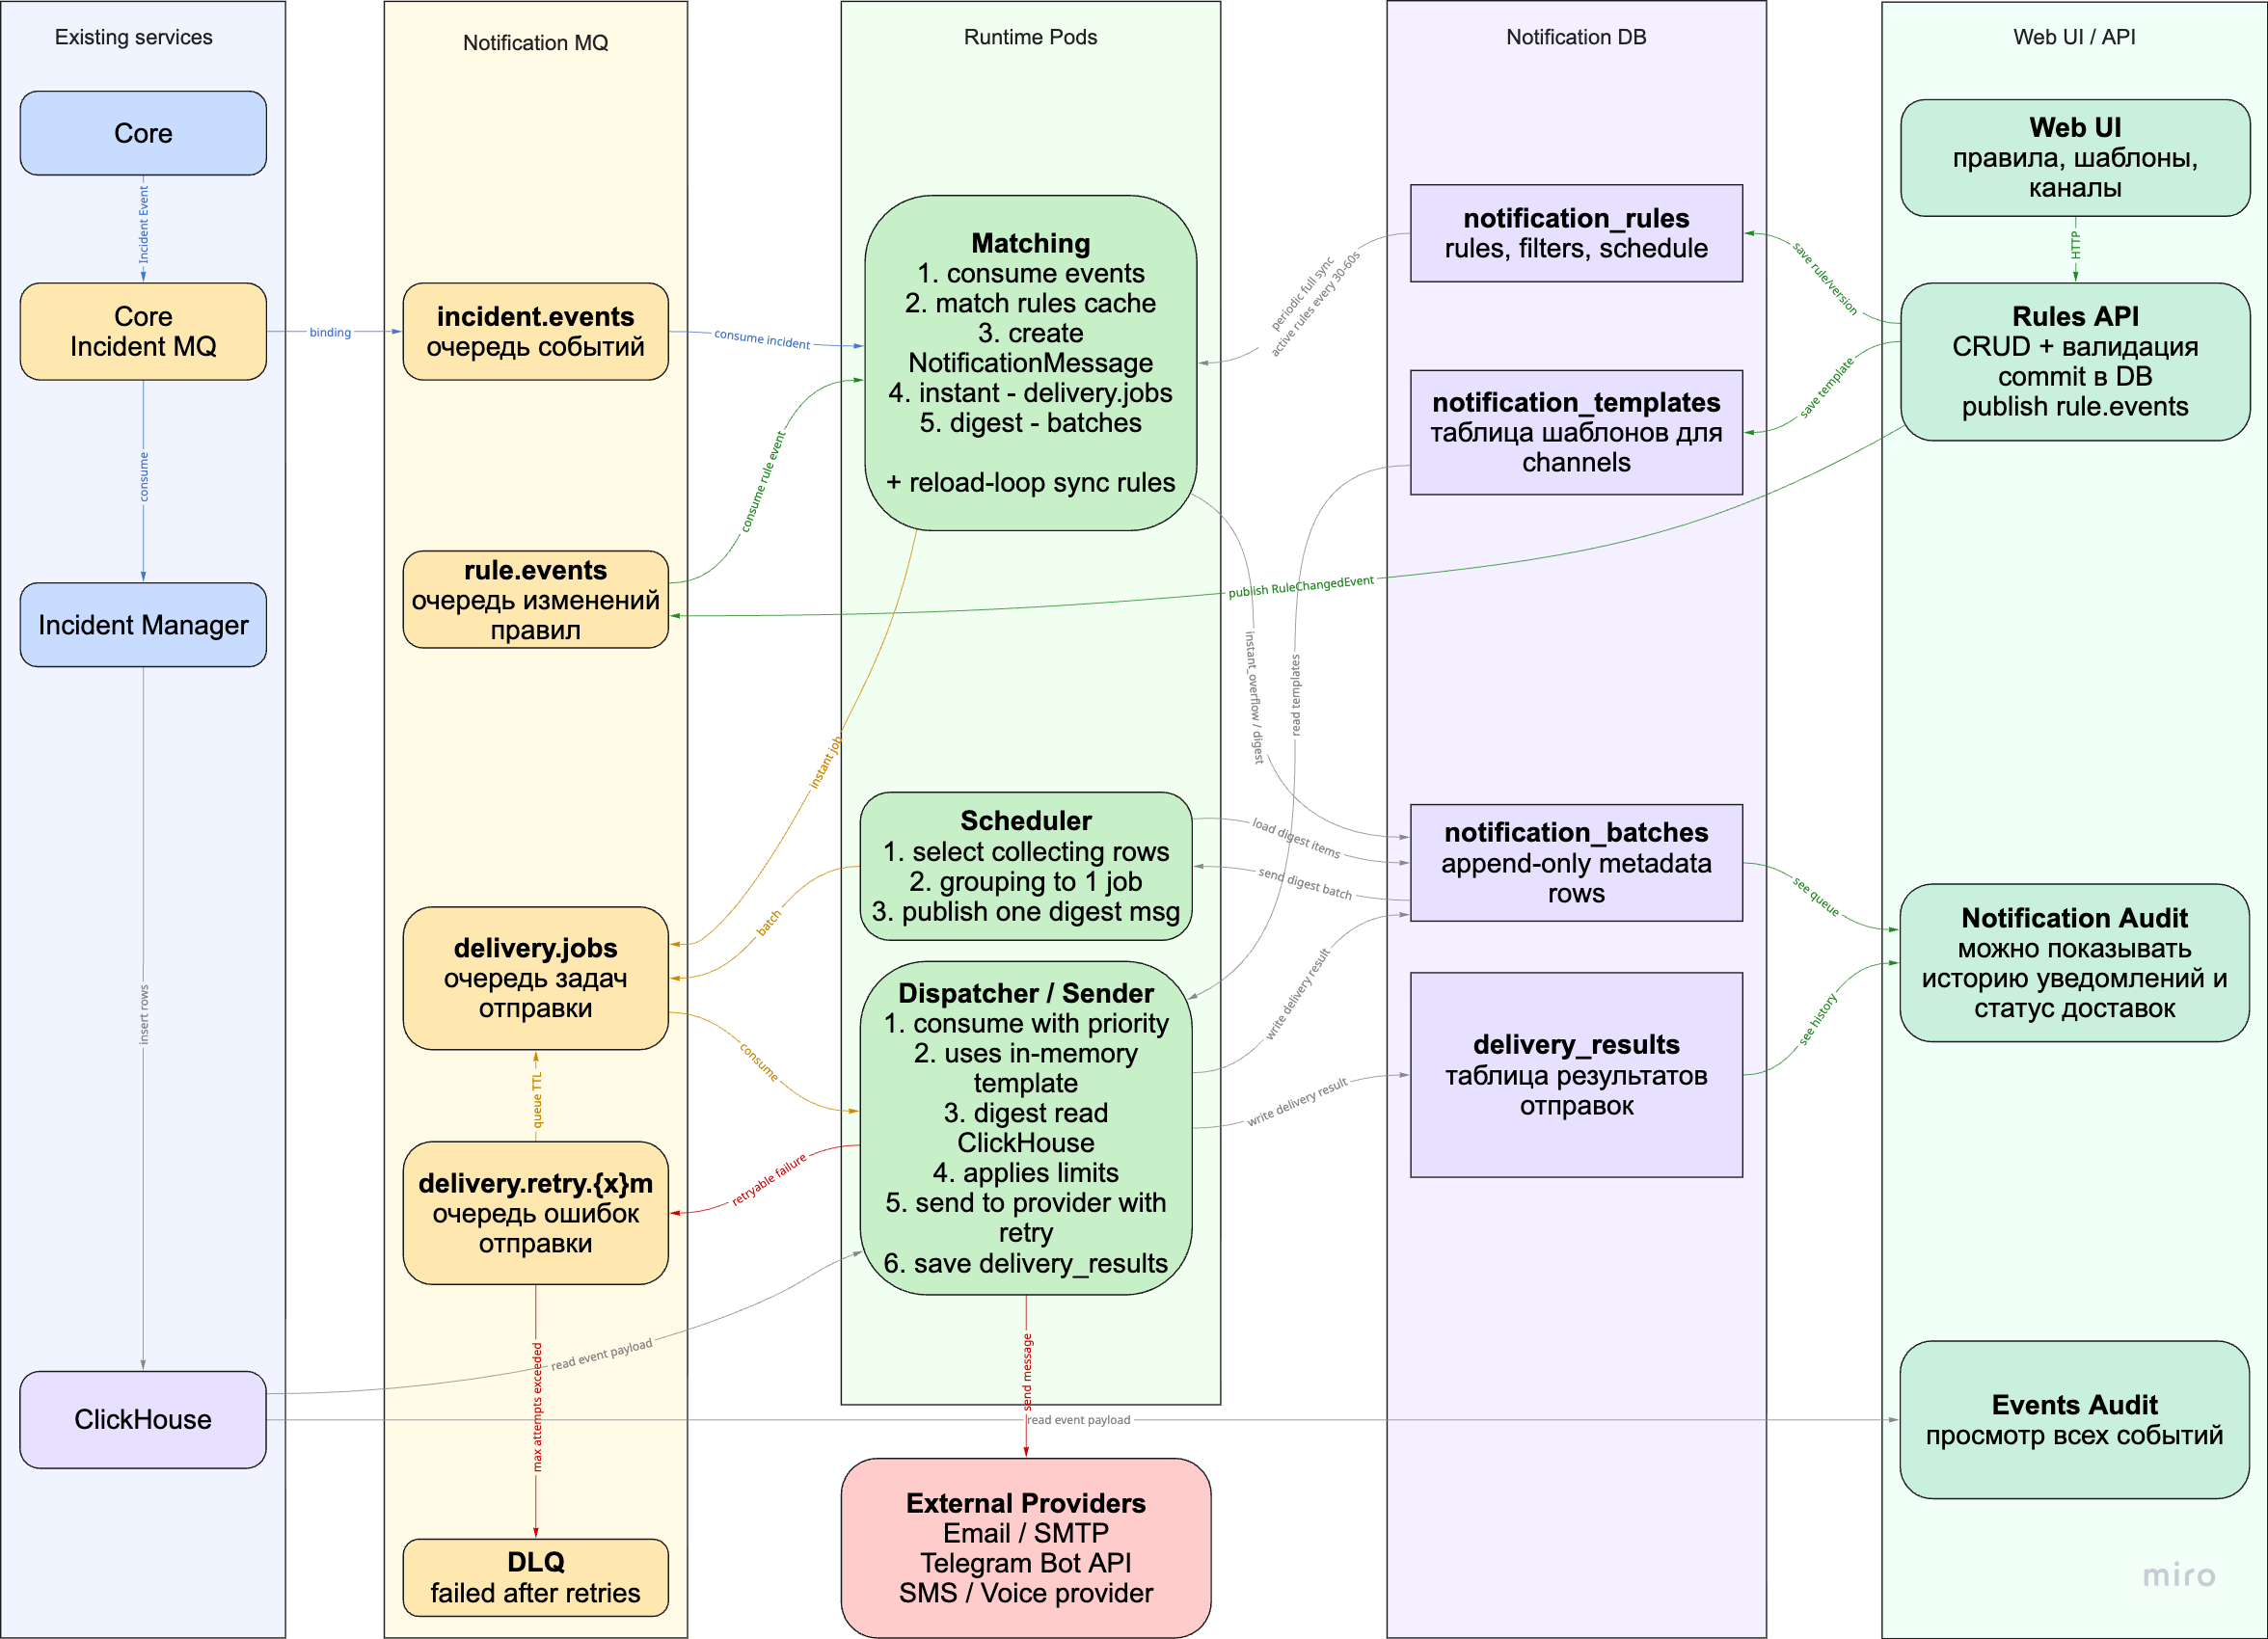
Задача
Спроектировать систему отправки уведомлений о событиях аудита безопасности.
Система должна позволять пользователям настраивать правила уведомлений, фильтровать события по параметрам инцидента, выбирать канал доставки и режим отправки: мгновенно или агрегированно за период. Источником событий является существующий сервис Core, который публикует IncidentEvent в RabbitMQ. Incident Manager сохраняет события в ClickHouse, а Notification Center параллельно читает live-поток событий, применяет правила и доставляет уведомления через выбранные каналы.
Домены Системы
1. Existing Core / Incident Domain
Это существующая часть системы. Notification Center ее не меняет.
Компоненты:
Core;Core / Incident MQ;Incident Manager;ClickHouse.
Поток:
Core -> Core / Incident MQ -> Incident Manager -> ClickHouse
                         \
                          -> Notification Runtime читает IncidentEvent
Notification Center только слушает live-поток IncidentEvent. Для instant-уведомлений полный payload инцидента передается в NotificationMessage. Для digest-уведомлений полные данные инцидентов остаются в ClickHouse и читаются оттуда при подготовке текста уведомления и при отображении audit UI.
2. Control Plane
Control Plane отвечает за настройку Notification Center.
Компоненты:
Web UI;Rules API;Notification DB;rule.events.
Через Control Plane пользователи и администраторы:
- создают и редактируют правила;
- настраивают каналы;
- настраивают шаблоны;
- смотрят историю уведомлений;
- смотрят статусы доставок.
Поток изменения правила:
- Пользователь меняет правило в
Web UI. Rules APIвалидирует изменение и сохраняет его вNotification DB.- После commit
Rules APIпубликуетRuleChangedEventвrule.events. - Matching-зона через отдельный reload-loop читает
RuleChangedEventи обновляет локальныйrules cacheс batching/debounce. - Matching-зона также делает startup load и periodic full sync активных правил из
Notification DB.
3. Notification Runtime
Runtime состоит из трех независимых зон:
Matching -> Scheduling -> Sending
Зоны связаны контрактами и не знают внутреннюю реализацию друг друга.
Runtime Flow
1. Matching
Зона Matching отвечает только за применение правил к IncidentEvent.
- Matching читает
IncidentEventизincident.events. - Matching применяет локальный
rules cache. - Если правило не совпало, обработка заканчивается.
- Если правило совпало, Matching создает
NotificationMessage. - В
NotificationMessageфиксируются:notification_uuid- новый UUID, который создается в Matching-зоне при формированииNotificationMessage;incident- массивIncidentEvent: для instant содержит один полныйIncidentEvent, для digest содержит элементыIncidentEventтолько с заполненнымevent_id;rule_id- правило, которое совпало с событием;- получатель - пользователь, команда или группа, которым нужно отправить уведомление;
- канал - способ доставки: email, Telegram, SMS, voice;
delivery_mode- режим отправки:instantилиdigest;- для digest:
period_start,period_end- bucket-период агрегированной отправки.
Для digest это рассчитанный bucket отправки. Например, для расписания “каждые 2 часа” в timezone правила будут bucket-периоды 00:00-02:00, 02:00-04:00, 04:00-06:00 и так далее; событие с occurred_at = 03:15 попадет в bucket 02:00-04:00:
period_start- начало bucket;period_end- конец bucket.
Маршрутизация:
instant -> delivery.jobs
digest  -> notification_batches
Для instant Matching публикует NotificationMessage в delivery.jobs.
Для digest Matching вставляет отдельную строку метаданных события в notification_batches. Это append-only insert: Matching не обновляет общую batch-строку, не собирает JSON-массив и не сохраняет payload инцидента.
2. Scheduling
Зона Scheduling отвечает только за формирование digest-сообщений из накопленных строк notification_batches.
- Scheduler ищет строки
notification_batchesсо статусомcollecting, у которыхperiod_end + scheduler_grace_period <= now(). scheduler_grace_period- заложенный фиксированный лаг на процессинг событий от Matching до записи в batch.- Scheduler группирует найденные строки по
tenant_id + rule_id + recipient_id + channel + period_start + period_end. - Для каждой группы Scheduler создает один
NotificationMessageвdelivery.jobs, гдеincidentсодержит списокevent_idэтого batch. - После постановки сообщения в очередь Scheduler помечает строки группы как
queuedи проставляет им общийbatch_uuid.
3. Sending
Зона Sending отвечает за подготовку render context и доставку NotificationMessage из delivery.jobs.
- Dispatcher читает
NotificationMessageизdelivery.jobs, отдавая приоритетinstant, но сохраняя квоту обработки дляdigest. - Dispatcher всегда работает с одинаковым верхнеуровневым форматом сообщения: поле
incidentсодержит массив. - Для instant в
incidentлежит один полный payload инцидента в формате ClickHouse. - Для digest в
incidentлежит списокevent_idэтого batch. - Dispatcher берет шаблон, контакты получателя и настройки канала из локальных in-memory snapshots.
- In-memory snapshots обновляются отдельным reload-loop по тикеру внутри Sending pod: loop читает актуальные данные из
Notification DB, строит новые snapshots и атомарно заменяет старые после успешной загрузки. - Для instant
NotificationMessageуже содержит данные для рендера: Dispatcher рендерит сообщение изincident[0]и не читает ClickHouse. - Для digest
NotificationMessageеще не содержит данные для рендера: Dispatcher читает из ClickHouse данные нескольких событий поrender_limitи формирует render context. - Dispatcher рендерит сообщение.
- Dispatcher отправляет сообщение во внешний канал.
- Результат отправки записывается в
delivery_results. - Для digest Dispatcher обновляет строки
notification_batches:sentпри успешной доставке,failedпри финальной ошибке.
Приоритет обработки задается на уровне delivery.jobs: instant-сообщения имеют более высокий delivery priority, digest-сообщения - более низкий. Приоритет не является абсолютной монополией: Dispatcher работает по fairness policy, например 100 instant -> 1 digest, через отдельные worker quotas или через разные Dispatcher deployment для instant и digest.
Пример digest:
1000 IncidentEvent -> 1000 metadata rows in notification_batches -> 1 NotificationMessage with 1000 event_id -> ClickHouse LIMIT 10 for render -> 1 email digest
Retry Flow
DLQ не должен быть первой точкой при ошибке отправки. Сначала используется retry.
DispatcherполучаетNotificationMessageизdelivery.jobs.- Если отправка успешна, пишет
sentвdelivery_results. - Если ошибка временная, например timeout провайдера:
- пишет failed attempt в
delivery_results; - публикует сообщение в
delivery.retry; - увеличивает
retry.attempt.
- пишет failed attempt в
delivery.retryвозвращает сообщение обратно вdelivery.jobsпосле задержки.- Если лимит попыток исчерпан или ошибка неретрайбл, сообщение уходит в
DLQ.
Для RabbitMQ это можно сделать без отдельного backend-worker через TTL + DLX:
delivery.retry.1m
  x-message-ttl = 60000
  x-dead-letter-exchange = notification.delivery
  x-dead-letter-routing-key = delivery.jobs

delivery.retry.5m
  x-message-ttl = 300000
  x-dead-letter-exchange = notification.delivery
  x-dead-letter-routing-key = delivery.jobs

delivery.retry.30m
  x-message-ttl = 1800000
  x-dead-letter-exchange = notification.delivery
  x-dead-letter-routing-key = delivery.jobs
NotificationMessage
NotificationMessage - первая внутренняя сущность Notification Center после совпадения правила.
Она создается в Matching-зоне из двух источников:
IncidentEvent + matched notification_rule -> NotificationMessage
Назначение NotificationMessage:
- зафиксировать, какое правило сработало;
- зафиксировать данные для рендера instant-уведомления или ссылки на события digest-batch;
- зафиксировать получателя;
- зафиксировать канал;
- передать downstream-сервисам все данные маршрутизации;
- дать downstream-сервисам поля для уникальных индексов и дедупликации.
Go-контракт:
import (
	"net"
	"time"

	"github.com/google/uuid"
)

// RecipientRef and ChannelRef are domain contracts defined outside this message contract.
type NotificationMessage struct {
	NotificationUUID uuid.UUID       `json:"notification_uuid"`
	TenantID         string          `json:"tenant_id"`
	Incident         []IncidentEvent `json:"incident"`
	RuleID           string          `json:"rule_id"`
	Recipient        RecipientRef    `json:"recipient"`
	Channel          ChannelRef      `json:"channel"`
	DeliveryMode     DeliveryMode    `json:"delivery_mode"`
	Digest           *DigestBucket   `json:"digest,omitempty"`
	Retry            *RetryState     `json:"retry,omitempty"`
}

type IncidentEvent struct {
	EventID    string         `json:"event_id"`
	EventType  EventType      `json:"event_type,omitempty"`
	OccurredAt time.Time      `json:"occurred_at,omitempty"`
	Severity   Severity       `json:"severity,omitempty"`
	IPAddress  net.IP         `json:"ip_address,omitempty"`
	Host       string         `json:"host,omitempty"`
	Payload    map[string]any `json:"payload,omitempty"`
}

type EventType string

const (
	EventTypeSuspiciousLogin EventType = "suspicious_login"
	EventTypeAuditViolation  EventType = "audit_violation"
	EventTypePolicyBreach    EventType = "policy_breach"
)

type Severity string

const (
	SeverityLow    Severity = "low"
	SeverityMiddle Severity = "middle"
	SeverityHigh   Severity = "high"
)

type DeliveryMode string

const (
	DeliveryModeInstant DeliveryMode = "instant"
	DeliveryModeDigest  DeliveryMode = "digest"
)

type DigestBucket struct {
	PeriodStart string `json:"period_start"`
	PeriodEnd   string `json:"period_end"`
	BatchKey    string `json:"batch_key"`
}

type RetryState struct {
	Attempt     int     `json:"attempt"`
	MaxAttempts int     `json:"max_attempts"`
	NextDelay   *string `json:"next_delay"`
	LastError   *string `json:"last_error"`
}
RecipientRef и ChannelRef остаются внешними доменными контрактами. Для Notification Runtime важно, что эти поля уже выбраны Matching-зоной и передаются дальше без повторного вычисления получателя или канала.
Семантика incident зависит от delivery_mode:
instant:incidentсодержит один полныйIncidentEvent, достаточный для рендера без чтения ClickHouse;digest:incidentсодержит списокIncidentEvent, где заполнено только полеevent_id.
Пример:
{
  "notification_uuid": "uuid",
  "tenant_id": "company-a",
  "incident": [
    {
      "event_id": "incident-456",
      "event_type": "suspicious_login",
      "occurred_at": "2026-06-15T10:20:30Z",
      "severity": "high",
      "ip_address": "10.10.1.5",
      "host": "auth-node-01",
      "payload": {
        "geo": "RU",
        "auth_method": "password",
        "failed_attempts": 7
      }
    }
  ],
  "rule_id": "rule-123",
  "recipient": {
    "recipient_type": "team",
    "recipient_id": "soc-team"
  },
  "channel": {
    "channel": "email"
  },
  "delivery_mode": "instant"
}
Дальше этот объект маршрутизируется одним из двух способов:
NotificationMessage(mode=instant) -> delivery.jobs
NotificationMessage(mode=digest)  -> metadata row in notification_batches
Для instant в delivery.jobs попадает полный payload одного инцидента в том же формате, в котором событие хранится в ClickHouse. Dispatcher рендерит instant-уведомление из incident[0] и не читает ClickHouse.
Для digest в delivery.jobs попадает список event_id этого batch. Dispatcher читает из ClickHouse только события, нужные для рендера digest.
В notification_batches дополнительно хранятся metadata-поля, нужные для batch-статуса, audit UI и технических выборок.
Для digest добавляются поля периода:
{
  "digest": {
    "period_start": "2026-06-15T00:00:00Z",
    "period_end": "2026-06-16T00:00:00Z",
    "batch_key": "rule-123:soc-team:email:2026-06-15"
  }
}
period_start и period_end рассчитывает Matching-зона, потому что она уже держит rules cache и знает расписание правила. Scheduling-зона не перечитывает правило и не вычисляет расписание сама.
Это bucket-based digest. Matching-зона не смотрит историю прошлых отправок. Она детерминированно вычисляет bucket из:
IncidentEvent.occurred_at
rule.schedule_interval
rule.schedule_unit
rule.timezone / tenant timezone
Все события, попавшие в один bucket, получают одинаковые:
period_start
period_end
И поэтому Scheduler позже группирует строки notification_batches по ключу:
tenant_id + rule_id + recipient_id + channel + period_start + period_end
Примеры расчета:
rule: every 1 hour
event.occurred_at = 2026-06-15 10:23:00
period_start      = 2026-06-15 10:00:00
period_end        = 2026-06-15 11:00:00
rule: every 30 minutes
event.occurred_at = 2026-06-15 10:23:00
period_start      = 2026-06-15 10:00:00
period_end        = 2026-06-15 10:30:00
Downstream-сервисы получают из NotificationMessage уже выбранные правило, канал и получателя.
Для digest NotificationMessage.incident содержит ссылки на инциденты в ClickHouse:
{
  "incident": [
    { "event_id": "incident-456" },
    { "event_id": "incident-457" }
  ]
}
Полные поля digest-инцидентов для шаблонов и audit UI читаются из ClickHouse по tenant_id и incident[].event_id.
Ограничения отображения применяются на этапе рендера в Sending-зоне. Например, email-шаблон может вывести первые 10 инцидентов, прочитанных из ClickHouse, и добавить ссылку на Events Audit в UI для просмотра полной детализации:
{
  "render_policy": {
    "max_incidents_in_message": 10,
    "details_url": "https://notification-center/events-audit?batch_uuid=batch-789"
  }
}
Дедупликация обеспечивается уникальными индексами по бизнес-полям.
Для event-level уведомлений:
unique(event_id, rule_id, channel, recipient_id)
Перед отправкой NotificationMessage содержит retry-блок:
{
  "notification_uuid": "uuid",
  "retry": {
    "attempt": 0,
    "max_attempts": 4,
    "next_delay": null,
    "last_error": null
  }
}
Для instant в incident лежит один полный payload инцидента. Для digest Scheduler создает NotificationMessage, где incident содержит список event_id из сгруппированных строк notification_batches.
{
  "notification_uuid": "uuid",
  "tenant_id": "company-a",
  "delivery_mode": "digest",
  "incident": [
    { "event_id": "incident-456" },
    { "event_id": "incident-457" }
  ]
}
При временной ошибке Dispatcher публикует тот же NotificationMessage в delivery.retry, увеличив retry.attempt и выставив retry.next_delay.
Пример retry-сообщения:
{
  "notification_uuid": "uuid",
  "retry": {
    "attempt": 1,
    "max_attempts": 4,
    "next_delay": "PT1M",
    "last_error": "provider_timeout"
  }
}
Блоки Системы
Existing Services
Core
Существующий сервис, который детектит события аудита безопасности.
Ответственность:
- сформировать
IncidentEvent; - опубликовать событие в
Core / Incident MQ; - не знать о правилах уведомлений, шаблонах и каналах доставки.
Core / Incident MQ
Существующий RabbitMQ-контур для событий безопасности.
Публикуемый контракт:
{
  "event_id": "uuid",
  "tenant_id": "company-a",
  "occurred_at": "2026-06-15T10:20:30Z",
  "severity": "low | middle | high",
  "event_type": "suspicious_login",
  "ip_address": "10.10.1.5",
  "payload": {}
}
Incident Manager
Существующий сервис хранения истории инцидентов.
Ответственность:
- читать
IncidentEvent; - сохранять события в ClickHouse;
- предоставлять исторические данные для аналитики и расследований.
ClickHouse
Хранилище истории инцидентов.
Используется для:
- поиска по истории событий;
- аналитики;
- расследований;
- отображения полного списка событий в UI;
- чтения деталей инцидентов при рендере уведомлений.
ClickHouse не является источником триггеров для live-уведомлений. Триггеры читаются из MQ, а детали события для текста уведомления читаются из ClickHouse.
Notification MQ
RabbitMQ-контур Notification Center. Он не хранит 30-дневные digest-данные. MQ используется как транспорт короткоживущих рабочих сообщений.
incident.events
Очередь или binding на поток IncidentEvent.
Читатель:
- Matching-зона.
Назначение:
- передать live-инциденты в Notification Center.
incident.events должен мониториться в Prometheus:
- queue depth;
- oldest message age;
- publish rate;
- consume rate;
- consumer count;
- error / redelivery rate.
Matching workers масштабируются по backlog и oldest message age. Если событий стало больше, чем текущие workers успевают обрабатывать, autoscaling добавляет второй, третий и следующие Matching pod. Scaling policy использует cooldown period, чтобы pods не флапали при кратковременных всплесках.
rule.events
Очередь изменений правил.
Писатель:
Rules API.
Читатель:
- Matching-зона.
Контракт:
{
  "event_type": "notification_rule.created | notification_rule.updated | notification_rule.disabled",
  "tenant_id": "company-a",
  "rule_id": "rule-123",
  "occurred_at": "2026-06-15T10:21:00Z"
}
Событие не обязано содержать полное правило. Достаточно rule_id, чтобы Matching-зона перечитала актуальные данные из Notification DB.
rule.events не дергает горячий путь матчинга напрямую. Обновление правил обрабатывается отдельным reload-loop внутри Matching-зоны:
- reload-loop читает пачку
RuleChangedEventизrule.events; - собирает уникальные
tenant_id + rule_id; - подтверждает прочитанные MQ-сообщения;
- выполняет один sync актуальных правил из
Notification DB; - атомарно заменяет локальный
rules cache; - ждет фиксированный debounce-интервал по тикеру;
- затем читает следующую пачку изменений.
Если за debounce-интервал пришло 10 update-событий по одному правилу, Matching-зона делает один reload правила, а не 10 последовательных запросов в БД. Частый CRUD правил от одного клиента не должен становиться ручкой для нагрузки на hot path матчинга.
delivery.jobs
Очередь задач отправки уведомлений.
Писатели:
- Matching-зона для instant-уведомлений на основе
NotificationMessage; - Scheduling-зона для digest-уведомлений;
delivery.retryчерез TTL + DLX после задержки.
Читатель:
- Sending-зона.
Важно: в очереди лежит один тип сообщения NotificationMessage. Для instant и digest структура одинаковая; различаются delivery_mode и размер массива incident.
Различается содержимое incident:
instant: один элемент с полным payload инцидента;digest: списокevent_idсобытий batch.
Приоритет доставки:
instant: высокий priority;digest: низкий priority.
Приоритет ограничен fairness policy. Instant-сообщения получают больше пропускной способности, но не могут полностью вытеснить digest, retry и служебные отправки.
В RabbitMQ это можно реализовать несколькими способами:
- одна priority queue (
x-max-priority) и свойство сообщенияpriority; - две физические очереди внутри логического
delivery.jobsчерез headers/routing:delivery_mode = instantпопадает в высокоприоритетную очередь, аdelivery_mode = digest- в низкоприоритетную; - два deployment Dispatcher: один читает instant-очередь, второй читает digest-очередь.
При варианте с двумя физическими очередями один Dispatcher читает их по weighted policy, например N сообщений из instant-очереди и затем M сообщений из digest-очереди. При варианте с двумя deployment fairness задается квотами и autoscaling policy для каждого deployment.
delivery.jobs должен мониториться в Prometheus:
- queue depth по instant/digest;
- oldest message age;
- publish rate;
- consume rate;
- retry rate;
- DLQ rate.
Количество Dispatcher workers масштабируется так, чтобы backlog delivery.jobs в нормальном режиме стремился к нулю, а oldest message age оставался ниже целевого SLA. При массовой атаке на многих клиентов одновременно, когда per-rule и per-recipient ограничения не срабатывают как единый ограничитель, Dispatcher масштабируется горизонтально и переваривает всплеск на повышенных мощностях.
delivery.retry
Логический блок retry-очередей.
Назначение:
- отложить повторную отправку после временной ошибки;
- вернуть сообщение обратно в
delivery.jobsпосле delay; - не требовать отдельный backend-worker для переноса сообщений.
Реализация в RabbitMQ:
- TTL queue;
- DLX routing обратно в
delivery.jobs; - несколько очередей для разных backoff-интервалов.
DLQ
Dead-letter queue для сообщений, которые не удалось обработать.
Сюда попадают:
- сообщения после исчерпания retry attempts;
- неретрайбл ошибки;
- некорректные сообщения, которые нельзя обработать автоматически.
DLQ нужен для ручного разбора, алертов и возможного replay после исправления причины.
Notification Runtime Zones
Runtime-зоны не должны хранить долгоживущее состояние локально. Долгие данные лежат в Notification DB.
Matching
Зона матчинга событий по правилам.
Ответственность:
- читать
IncidentEventизincident.events; - отдавать метрики обработки
incident.eventsдля Prometheus; - держать локальный
rules cache; - матчить событие по фильтрам;
- выполнять pipeline проверки составных правил асинхронно;
- создавать
NotificationMessageпосле совпадения правила; - для digest рассчитывать
period_startиperiod_end; - вставлять digest-метаданные в
notification_batches; - публиковать
NotificationMessageвdelivery.jobsдля instant в рамках instant rate limit; - переводить instant overflow в digest-batch, когда лимит instant-отправок превышен;
- читать
RuleChangedEventизrule.events; - перечитывать измененные правила из
Notification DB; - делать startup load всех active rules;
- делать periodic full sync правил.
Правила не читаются из БД на каждое событие, иначе БД станет bottleneck. Основной путь матчинга идет через локальный cache.
Проверка составного правила выполняется как параллельный pipeline. Отдельные фильтры правила, например severity, IP/CIDR, event type и дополнительные предикаты, запускаются в worker-группе с общим context. Если один worker возвращает ошибку, Matching отменяет context остальных worker и завершает проверку правила с ошибкой. Если фильтр возвращает false, правило считается несовпавшим, и оставшиеся проверки для этого правила тоже останавливаются через cancellation. Это позволяет быстро обрабатывать составные правила и не тратить CPU на проверки, результат которых уже не изменит итог.
Scheduling
Зона, которая превращает готовые digest-batches в сообщения для отправки.
Ответственность:
- периодически искать строки
notification_batches, у которыхstatus = 'collecting'иperiod_end + scheduler_grace_period <= now(); - блокировать выбранные строки на обработку;
- сгруппировать строки по
tenant_id,rule_id,recipient_id,channel,period_start,period_end; - создать один
NotificationMessageна каждую группу:incidentсодержит списокevent_idэтого batch; - поменять статус строк группы на
queuedи проставить общийbatch_uuid.
scheduler_grace_period - системная задержка перед отправкой закрытого bucket. Она нужна, чтобы события, пришедшие на границе bucket, успели пройти цепочку Core -> MQ -> Matching -> notification_batches, а Incident Manager успел сохранить инциденты в ClickHouse.
Типовая выборка:
SELECT *
FROM notification_batches
WHERE status = 'collecting'
  AND period_end <= now() - interval '60 seconds'
ORDER BY period_end
LIMIT 100
FOR UPDATE SKIP LOCKED;
Sending
Зона отправки уведомлений.
Ответственность:
- читать
NotificationMessageизdelivery.jobs; - выбрать шаблон по
rule_id,channelиdelivery_modeиз локального in-memory snapshot; - выбрать контакты и настройки каналов из локальных in-memory snapshots;
- для instant рендерить сообщение из полного payload в
incident[0]без чтения ClickHouse; - для digest читать детали инцидентов из ClickHouse по
tenant_idиincident[].event_idдля рендера; - для digest применять лимит отображения из шаблона или channel policy, например первые 10 инцидентов для email digest;
- применять channel/provider/account rate limits перед вызовом внешнего provider;
- рендерить сообщение;
- отправлять сообщение во внешний provider;
- писать результат в
delivery_results; - отправлять временные ошибки в
delivery.retry; - отправлять финальные ошибки в
DLQ; - для digest закрывать связанные строки
notification_batchesстатусомsentилиfailed; - отдавать метрики обработки для Prometheus: обработано сообщений, ошибки, latency, retry, DLQ, provider/account rate limit.
Dispatcher выбирает шаблон по ключу:
tenant_id + rule_id + channel + delivery_mode
Шаблоны, контакты и настройки каналов не читаются из Notification DB в hot path обработки delivery.jobs.
Их обновляет отдельная background goroutine внутри Sending pod:
- reload-loop по тикеру читает актуальные шаблоны, контакты и настройки каналов из
Notification DB; - строит новые in-memory snapshots;
- после успешного чтения атомарно заменяет старый snapshot новым;
- Dispatcher workers читают runtime-конфигурацию только из текущих snapshots в памяти;
- если очередной reload из БД завершился ошибкой, старый snapshot остается активным;
Notification DBостается source of truth.
Это снижает нагрузку при массовых отправках и изолирует hot path отправки от временной деградации Notification DB: если БД занята или недоступна, Dispatcher продолжает отправку по последним успешно загруженным snapshots.
Подписка Dispatcher на события изменения шаблонов, контактов или каналов не обязательна для базовой архитектуры. Ее можно добавить как оптимизацию: Rules API публикует TemplateChangedEvent или другой config event в отдельную очередь, reload-loop делает внеочередной reload нужного ключа или всего snapshot. Ticker-based reload достаточно для базовой схемы, потому что конфигурация меняется реже, чем обрабатываются сообщения, а интервал reload ограничивает окно устаревших данных.
Если Dispatcher в digest-режиме не находит нужный event_id в ClickHouse, это считается временным состоянием индексации или записи. Сообщение уходит в retry с короткой задержкой, а не в DLQ.
Контракт чтения деталей инцидентов для digest:
SELECT *
FROM security_incidents
WHERE tenant_id = :tenant_id
  AND event_id IN (:event_ids)
ORDER BY occurred_at
LIMIT :render_limit;
Для digest event_ids берется из NotificationMessage.incident и содержит список событий этого batch. Dispatcher применяет render_limit из шаблона или channel policy, например 10 инцидентов для email digest, и после чтения ClickHouse формирует render context с обогащенными данными инцидентов.
Digest render context содержит:
rendered_events_count- сколько событий выведено в текст уведомления;events_count = len(NotificationMessage.incident)- полный размер batch;hidden_events_count = events_count - rendered_events_count;events_audit_url- ссылка на Events Audit web UI для полного просмотра batch.
Если hidden_events_count > 0, шаблон добавляет строку вида “и еще Y событий за период”. Если hidden_events_count = 0, эта строка не выводится. Ссылка на Events Audit web UI добавляется всегда.
Notification DB
Одна БД сервиса Notification Center. Внутри нее разные группы таблиц.
notification_rules
Таблица актуальных правил уведомлений.
Пример данных:
rule_id;tenant_id;name;enabled;owner_id;created_at;updated_at.
Пример структуры правила:
{
  "rule_id": "rule-123",
  "filters": {
    "severity": ["high"],
    "ip_address": ["185.10.0.0/16"],
    "event_type": ["suspicious_login"]
  },
  "channels": ["email", "telegram"],
  "schedule": {
    "mode": "digest",
    "interval": 1,
    "unit": "days"
  },
  "template_policy": "default"
}
notification_templates
Шаблоны уведомлений.
Примеры:
- email HTML template;
- Telegram text / Markdown template;
- SMS text template;
- voice call text / scenario.
Шаблон выбирается Dispatcher по данным сообщения и конфигурации:
tenant_id + rule_id + channel + delivery_mode
Dispatcher читает шаблон из локального in-memory snapshot, который обновляется background reload-loop по тикеру. Массовая отправка по одному правилу и каналу не создает чтение notification_templates на каждое сообщение. Опционально можно добавить template.events, чтобы TemplateChangedEvent запускал внеочередной reload snapshot, но в базовой архитектуре это не обязательно.
Matching-зона не выбирает шаблон и не передает template_id в downstream-сообщениях.
contacts / channels
Контакты пользователей, команд и каналов доставки.
Примеры:
- email address;
- Telegram chat id;
- phone number;
- enabled/disabled channel;
- verified/unverified contact.
notification_batches
Таблица накопленных метаданных для digest-отправки.
Одна строка соответствует одному совпавшему событию, которое ожидает batch-отправки. Payload инцидента в этой таблице не хранится.
notification_batches хранит состояние отправки и ссылку на событие в ClickHouse через event_id. Полное содержимое инцидента, включая расширенные поля и payload, остается в ClickHouse.
Будущий batch определяется группой полей:
tenant_id + rule_id + recipient_id + channel + period_start + period_end
schedule_mode показывает, почему событие попало в batch:
digest- обычное правило с периодической отправкой;instant_overflow- instant-правило превысило rate limit и было агрегировано вместо немедленной отправки.
Go-контракт строки:
type NotificationBatchRow struct {
	ID               int64              `db:"id"`
	BatchUUID        *uuid.UUID         `db:"batch_uuid"`
	NotificationUUID uuid.UUID          `db:"notification_uuid"`
	TenantID         string             `db:"tenant_id"`
	RuleID           string             `db:"rule_id"`
	RecipientID      string             `db:"recipient_id"`
	Channel          string             `db:"channel"`
	ScheduleMode     BatchScheduleMode  `db:"schedule_mode"`
	PeriodStart      time.Time          `db:"period_start"`
	PeriodEnd        time.Time          `db:"period_end"`
	Status           BatchStatus        `db:"status"`
	EventID          string             `db:"event_id"`
	EventType        EventType          `db:"event_type"`
	OccurredAt       time.Time          `db:"occurred_at"`
	Severity         Severity           `db:"severity"`
	CreatedAt        time.Time          `db:"created_at"`
	QueuedAt         *time.Time         `db:"queued_at"`
	SentAt           *time.Time         `db:"sent_at"`
	UpdatedAt        time.Time          `db:"updated_at"`
}

type BatchScheduleMode string

const (
	BatchScheduleModeDigest          BatchScheduleMode = "digest"
	BatchScheduleModeInstantOverflow BatchScheduleMode = "instant_overflow"
)

type BatchStatus string

const (
	BatchStatusCollecting BatchStatus = "collecting"
	BatchStatusQueued     BatchStatus = "queued"
	BatchStatusSent       BatchStatus = "sent"
	BatchStatusFailed     BatchStatus = "failed"
)
period_end - главное поле для Scheduler. Scheduler применяет к нему системную задержку scheduler_grace_period.
Пример:
period_start = 2026-06-15 00:00:00
period_end   = 2026-06-16 00:00:00
status       = collecting
Возможные статусы:
collecting -> queued -> sent
                      -> failed
Владельцы смены статусов:
MatchingилиAggregatorвставляет строку со статусомcollecting;Schedulerпосле публикации digestNotificationMessageвdelivery.jobsпереводит выбранные строки вqueuedи проставляетbatch_uuid;Dispatcherпосле успешной финальной отправки digest переводит строки batch вsentи заполняетsent_at;Dispatcherпосле финальной неретрайбл ошибки или исчерпания retry attempts переводит строки batch вfailed.
Matching-зона не ищет и не обновляет общую batch-строку. Она только вставляет новую строку метаданных:
INSERT INTO notification_batches (
  notification_uuid,
  tenant_id,
  rule_id,
  recipient_id,
  channel,
  schedule_mode,
  period_start,
  period_end,
  status,
  event_id,
  event_type,
  occurred_at,
  severity,
  created_at
) VALUES (...);
Scheduler не вычисляет расписание заново из правила. Он выбирает готовые строки по period_end с учетом scheduler_grace_period, группирует их и собирает один NotificationMessage на группу.
Пример:
{
  "event_id": "incident-456",
  "occurred_at": "2026-06-15T10:20:30Z",
  "severity": "high",
  "event_type": "suspicious_login"
}
При создании digest-сообщения Scheduler собирает:
NotificationMessage.incident = [{event_id}, {event_id}, ...]
После этого Dispatcher читает полные данные выбранных для рендера digest-событий из ClickHouse по tenant_id и event_id и формирует render context с реальными полями инцидентов. Например, для email digest с render_limit = 10 в ClickHouse читаются только 10 событий для рендера письма, а len(NotificationMessage.incident) показывает полный размер batch.
Дедупликация события:
unique(event_id, rule_id, recipient_id, channel, period_start, period_end)
delivery_attempts / delivery_results
История попыток и финальных результатов отправки.
Go-контракт строки:
type DeliveryResultRow struct {
	DeliveryMessageID uuid.UUID      `db:"delivery_message_id"`
	NotificationUUID  uuid.UUID      `db:"notification_uuid"`
	BatchUUID         *uuid.UUID     `db:"batch_uuid"`
	RuleID            string         `db:"rule_id"`
	EventsCount       int            `db:"events_count"`
	EventIDs          []string       `db:"event_ids_json"`
	RecipientID       string         `db:"recipient_id"`
	Channel           string         `db:"channel"`
	Attempt           int            `db:"attempt"`
	Status            DeliveryStatus `db:"status"`
	ProviderMessageID *string        `db:"provider_message_id"`
	ErrorCode         *string        `db:"error_code"`
	ErrorMessage      *string        `db:"error_message"`
	CreatedAt         time.Time      `db:"created_at"`
	FinishedAt        *time.Time     `db:"finished_at"`
}

type DeliveryStatus string

const (
	DeliveryStatusPending DeliveryStatus = "pending"
	DeliveryStatusSent    DeliveryStatus = "sent"
	DeliveryStatusFailed  DeliveryStatus = "failed"
	DeliveryStatusRetry   DeliveryStatus = "retry"
)
Для instant-уведомлений уникальность финальной доставки можно контролировать индексом:
unique(event_id, rule_id, channel, recipient_id)
Для digest-уведомлений:
unique(notification_uuid, rule_id, channel, recipient_id)
Web UI / API
Web UI
Интерфейс для пользователей и администраторов.
Функции:
- создание правил;
- редактирование правил;
- выбор severity, IP-фильтров, каналов и расписания;
- настройка шаблонов;
- просмотр истории уведомлений;
- просмотр статусов доставки.
Rules API
API управления конфигурацией Notification Center.
Ответственность:
- CRUD правил;
- CRUD шаблонов;
- CRUD контактов и каналов;
- валидация правил;
- сохранение изменений в
Notification DB; - публикация
RuleChangedEventпосле commit.
В этой версии архитектуры outbox не используется. Надежность восстановления обеспечивается тем, что Notification DB остается source of truth, а Matching-зона делает startup load и periodic full sync.
Notification Audit
UI-раздел для истории уведомлений.
Источники данных:
notification_batches;delivery_attempts;delivery_results.- ClickHouse для деталей инцидентов.
Функции:
- показать, какое правило сработало;
- показать события внутри digest по метаданным batch и деталям из ClickHouse;
- показать статус отправки;
- показать ошибку провайдера;
- показать retry attempts.
External Providers
Внешние каналы доставки.
Поддерживаемые каналы:
- Email / SMTP;
- Telegram Bot API;
- SMS provider;
- Voice call provider.
Dispatcher должен изолировать особенности каждого провайдера:
- rate limits;
- timeout;
- retryable / non-retryable errors;
- provider message id;
- формат сообщения;
- ограничения длины сообщения.
Базовые Решения
Source of Truth
Notification DB является source of truth для:
- правил;
- шаблонов;
- контактов;
- digest batch metadata;
- результатов отправки.
ClickHouse является source of truth для полных данных инцидентов.
MQ не является хранилищем бизнес-состояния.
Rules Cache
Matching-зона матчится по локальному cache.
Обновление cache:
- быстрый путь:
RuleChangedEventчерез отдельный reload-loop с batching и debounce; - восстановление: startup load;
- страховка: periodic full sync.
Runtime Queue Autoscaling
Runtime-очереди масштабируют своих consumers по backlog, а не хранят бизнес-состояние.
Общие метрики для Prometheus:
- queue depth;
- oldest message age;
- publish rate;
- consume rate;
- consumer count;
- redelivery rate;
- error rate.
Autoscaling policy:
- если queue depth растет и oldest message age приближается к SLA, добавляются новые workers;
- если backlog стабильно снижается и oldest message age ниже SLA, лишние workers постепенно убираются;
- scale down выполняется с cooldown period, чтобы не было постоянного флаппинга;
- workers остаются stateless, а дедупликация и состояние обработки находятся в
Notification DBи уникальных индексах.
Для incident.events -> Matching это означает, что при росте входящего потока добавляются второй, третий и следующие Matching pod.
Для digest-агрегации действует тот же принцип. В текущей архитектуре Matching пишет digest-метаданные сразу в notification_batches, а Scheduler работает по Notification DB. Если digest ingestion выделяется в отдельную очередь digest.candidates и отдельный pod Aggregator, то digest.candidates -> Aggregator масштабируется по тем же метрикам: backlog, oldest message age, publish rate и consume rate. Несколько Aggregator pod пишут append-only строки в notification_batches, а уникальный индекс unique(event_id, rule_id, recipient_id, channel, period_start, period_end) защищает от дублей.
Digest Storage
Долгие digest-периоды, например 30 дней, хранятся в Notification DB как метаданные batch, а не в MQ.
Это позволяет:
- деплоить pod-ы без потери накоплений;
- смотреть состояние batch;
- переотправлять уведомления;
- объяснять пользователю, почему было отправлено уведомление, связав batch metadata с деталями в ClickHouse;
- не превращать RabbitMQ в долгосрочное хранилище.
Instant Flood Protection
Instant-уведомления имеют приоритет, но ограничены rate limit. Одно шумное правило, получатель или tenant не может занять весь канал отправки.
Лимит применяется до публикации в delivery.jobs:
instant_rate_limit_key = tenant_id + rule_id + recipient_id + channel
Пример политики:
max 100 instant notifications per 1 minute per instant_rate_limit_key
Если лимит не превышен:
Matching -> delivery.jobs(priority=high, delivery_mode=instant)
Если лимит превышен:
Matching -> notification_batches(schedule_mode=instant_overflow)
instant_overflow обрабатывается в формате digest. События копятся в короткий bucket в notification_batches, Scheduler создает NotificationMessage с delivery_mode = digest, а Dispatcher читает данные накопленных event_id из ClickHouse и рендерит агрегированное уведомление по тем же правилам, что обычный digest.
Отличие только в тексте уведомления: шаблон добавляет пометку, что исходно это были instant-события, но они возникали слишком часто и были агрегированы. Полный список доступен через Events Audit web UI.
Dispatcher дополнительно применяет rate limits перед внешними provider:
email:    per recipient / tenant / sender address / sender IP
telegram: per chat / bot account
sms:      per phone / sender id / provider account
voice:    per phone / caller id / provider account
Provider/account rate limit не считается ошибкой провайдера. Сообщение откладывается в отдельный rate-limit retry/backoff или агрегируется в overflow, чтобы не создавать retry storm.
Расширение вне MVP: для отправляющих identities нужен резерв или пул аккаунтов. Если основной Telegram bot account, email sender/IP, SMS sender id или provider account подходит к лимиту, Dispatcher выбирает другой доступный аккаунт из пула и продолжает отправку. По заполнению лимитов и переключениям между аккаунтами нужны Prometheus-метрики и алерты.
Retry Policy
Рекомендуемый стартовый вариант:
attempt 1 failed -> delivery.retry.1m
attempt 2 failed -> delivery.retry.5m
attempt 3 failed -> delivery.retry.30m
attempt 4 failed -> DLQ
Неретрайбл ошибки можно отправлять в DLQ сразу.
Deduplication
Дедупликация нужна минимум в трех местах:
- Matching-зона: не добавить одно событие в batch дважды.
Scheduler: не создать два delivery-сообщения на один batch.Dispatcher: не отправить одно и то же уведомление дважды при повторной доставке сообщения.
Для этого используем уникальные индексы по бизнес-полям:
batch event row:
unique(event_id, rule_id, recipient_id, channel, period_start, period_end)

delivery message:
unique(notification_uuid, rule_id, channel, recipient_id)

instant delivery:
unique(event_id, rule_id, channel, recipient_id)
Edge Cases
Incident Events Backlog
Ситуация: incident.events получает больше событий, чем текущие Matching workers успевают обработать.
Поведение:
incident.eventsэкспортирует queue depth, oldest message age, publish rate, consume rate и redelivery rate в Prometheus;- autoscaling добавляет второй, третий и следующие Matching pod по backlog и oldest message age;
- Matching workers остаются stateless и используют общий
rules cachelifecycle: startup load, reload-loop, periodic full sync; - scale down выполняется с cooldown period, чтобы workers не флапали при коротких всплесках;
- дедупликация
notification_batchesи delivery защищает систему от повторной доставки при масштабировании consumers.
Digest Candidates Backlog
Ситуация: digest ingestion выделен в отдельную очередь digest.candidates, и Aggregator не успевает перекладывать кандидаты в notification_batches.
Поведение:
digest.candidatesэкспортирует queue depth, oldest message age, publish rate и consume rate в Prometheus;- autoscaling добавляет новые Aggregator pod по backlog и oldest message age;
- Aggregator workers остаются stateless и пишут append-only строки в
notification_batches; - уникальный индекс
unique(event_id, rule_id, recipient_id, channel, period_start, period_end)защищает от дублей при параллельной обработке; - scale down выполняется с cooldown period.
В текущей архитектуре отдельной digest.candidates очереди нет: Matching сразу пишет digest-метаданные в notification_batches. Если эта стадия выделяется в отдельный Aggregator pod, применяется описанная политика.
Instant Flood
Ситуация: правило настроено как instant, и по нему начинается поток событий, например 10k rps из-за атаки или ошибочного скрипта.
Поведение:
- Matching применяет instant rate limit по ключу
tenant_id + rule_id + recipient_id + channel; - события в пределах лимита публикуются в
delivery.jobsс высоким priority; - события сверх лимита пишутся в
notification_batchesсschedule_mode = instant_overflow; instant_overflowотправляется в формате digest: Dispatcher читает накопленные события из ClickHouse и рендерит агрегированное уведомление;- шаблон добавляет пометку, что instant-события возникали слишком часто и были агрегированы;
- полный список событий доступен через Events Audit web UI.
Instant Priority Starvation
Ситуация: поток instant-сообщений постоянный и может вытеснить digest-отправки.
Поведение:
- instant имеет более высокий priority, но не абсолютную монополию;
- Dispatcher работает по fairness policy, например
100 instant -> 1 digest; - при варианте с двумя физическими очередями Dispatcher читает очереди по weighted policy;
- при варианте с двумя deployment отдельные Dispatcher pools получают свои квоты и autoscaling policy;
- digest, retry и служебные отправки сохраняют минимальную квоту обработки.
Multi-Tenant Attack Burst
Ситуация: атака идет сразу по многим клиентам или правилам, поэтому per-rule/per-recipient ограничения не дают одного узкого ограничителя, и в delivery.jobs появляется большой backlog.
Поведение:
- RabbitMQ queue depth, oldest message age, publish rate, consume rate, retry rate и DLQ rate экспортируются в Prometheus;
- autoscaling увеличивает количество Dispatcher workers по backlog и oldest message age;
- для instant и digest можно держать отдельные Dispatcher deployment, чтобы масштабировать их независимо;
- целевое состояние: backlog
delivery.jobsстремится к нулю, а oldest message age остается ниже SLA; - когда всплеск заканчивается, autoscaling возвращает Dispatcher workers к обычной мощности.
Template DB Hotspot
Ситуация: много Dispatcher workers одновременно обрабатывают массовую отправку по одному правилу и каналу.
Поведение:
- Dispatcher выбирает шаблон по ключу
tenant_id + rule_id + channel + delivery_mode; - Dispatcher читает шаблон из локального in-memory snapshot;
- hot path отправки не читает
notification_templates; - background template reload-loop по тикеру обновляет snapshot из
Notification DB; - успешный reload атомарно заменяет snapshot;
- ошибка reload не ломает отправку: Dispatcher продолжает работать на последнем успешном snapshot;
- опциональный
TemplateChangedEventможет запускать внеочередной reload; - без
TemplateChangedEventsource of truth остаетсяNotification DB, а окно устаревшего шаблона ограничено интервалом reload.
Provider Rate Limit
Ситуация: внешний provider ограничивает отправку не только по получателю, но и по аккаунту отправителя, например Telegram bot account, SMS sender id, email sender address или sender IP.
Поведение:
- Dispatcher применяет channel/provider/account rate limits до вызова provider;
- лимиты проверяются по получателю и по отправляющей identity: bot account, sender id, sender address, sender IP, provider account;
- provider/account rate limit не считается ошибкой provider;
- вне MVP поддерживается резервный аккаунт или пул отправляющих аккаунтов для переключения при приближении к лимиту основного аккаунта;
- лимиты отправляющих аккаунтов, переключения и исчерпание пула мониторятся в Prometheus и алертятся;
- сообщение откладывается в rate-limit retry/backoff или агрегируется в overflow;
- система не создает retry storm.
ClickHouse Lag For Digest
Ситуация: digest-сообщение готово, но часть event_id еще не появилась в ClickHouse из-за лага Incident Manager.
Поведение:
- Scheduler ждет закрытия bucket с учетом
scheduler_grace_period; - если Dispatcher все равно не находит нужный
event_idв ClickHouse, это временное состояние; - сообщение уходит в retry с короткой задержкой;
- в DLQ оно попадает только после исчерпания retry attempts или неретрайбл ошибки.
Instant Does Not Depend On ClickHouse
Ситуация: instant-уведомление нужно отправить сразу, а ClickHouse может еще не содержать событие.
Поведение:
- Matching кладет полный payload инцидента в
NotificationMessage.incident[0]; - Dispatcher рендерит instant из payload сообщения;
- ClickHouse для instant-рендера не читается.
Late Events On Bucket Boundary
Ситуация: событие произошло в конце bucket, а обработка через Core -> MQ -> Matching -> notification_batches заняла время.
Поведение:
- Matching рассчитывает
period_startиperiod_endпоIncidentEvent.occurred_at; - Scheduler выбирает batch только после
period_end + scheduler_grace_period; - late event успевает попасть в правильный bucket до отправки.
Rule Events Lost Or Delayed
Ситуация: Rules API сохранил правило в Notification DB, но RuleChangedEvent не дошел до Matching или Matching был недоступен.
Поведение:
- быстрый путь обновления cache идет через
rule.events; - восстановление идет через startup load активных правил;
- страховка идет через periodic full sync из
Notification DB; Notification DBостается source of truth для правил.
Rule Update Spam
Ситуация: клиент часто меняет правила и генерирует много RuleChangedEvent.
Поведение:
- hot path матчинга продолжает работать по текущему локальному
rules cache; - reload правил выполняется отдельным reload-loop;
- reload-loop читает пачку событий, coalesce-ит их по
tenant_id + rule_idи делает один sync изNotification DB; - после sync reload-loop ждет debounce-интервал по тикеру;
- 10 update-событий по одному правилу за debounce-интервал приводят к одному перечитыванию правила;
- частый CRUD правил не создает прямую нагрузку на обработку
IncidentEvent.
Duplicate MQ Delivery
Ситуация: RabbitMQ повторно доставил IncidentEvent, NotificationMessage или retry-сообщение.
Поведение:
- batch-дедупликация защищена индексом
unique(event_id, rule_id, recipient_id, channel, period_start, period_end); - delivery-дедупликация защищена индексом
unique(notification_uuid, rule_id, channel, recipient_id); - instant delivery защищен индексом
unique(event_id, rule_id, channel, recipient_id).
Pod Restart During Digest Collection
Ситуация: Runtime pod перезапущен во время накопления digest за длинный период, например 30 дней.
Поведение:
- digest-состояние хранится в
notification_batches, а не в памяти pod и не в MQ; - новый pod продолжает обработку с
Notification DB; - Scheduler выбирает готовые строки по
period_end + scheduler_grace_period.
Partial Digest Render
Ситуация: batch содержит больше событий, чем можно показать в канале, например 1000 событий и лимит 10 строк в email.
Поведение:
NotificationMessage.incidentсодержит списокevent_idвсего batch;- Dispatcher читает из ClickHouse только
render_limitсобытий для текста уведомления; - render context вычисляет
events_count = len(NotificationMessage.incident),rendered_events_count,hidden_events_count; - строка “и еще Y событий за период” выводится только при
hidden_events_count > 0; - ссылка на Events Audit web UI добавляется всегда.
Provider Or Template Non-Retryable Error
Ситуация: сообщение невозможно отправить автоматически, например неверный телефон, невалидный шаблон или отключенный канал.
Поведение:
- Dispatcher пишет результат в
delivery_results; - неретрайбл ошибка отправляется в DLQ без долгой цепочки retry;
- DLQ используется для ручного разбора, алертов и возможного replay после исправления причины.